AI算力瓶颈破局 中科曙光发布共封装光学交换机,自研无损网络硬撼传统交换机市场
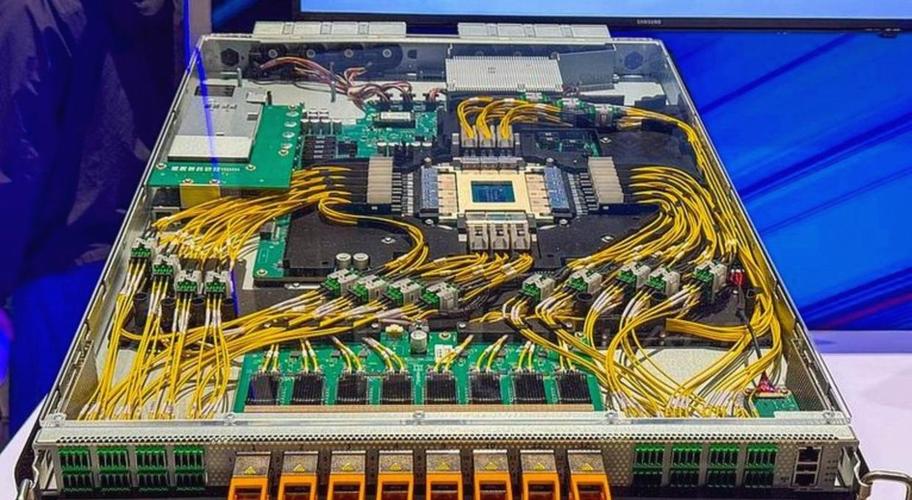
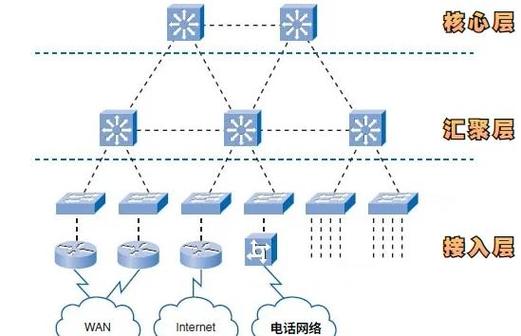
在近日举行的全球人工智能大会上,中科曙光(Sugon)投下了一枚重磅炸弹——正式发布其自研的“共封装光学(CPO)交换机”,并同步推出配套的无损网络解决方案。这一动作被业界视为直接向传统网络交换机巨头发起挑战,意图在AI大模型训练所依赖的高性能网络领域,打破原有的市场格局。\n\n## 传统网络遭遇AI“电老虎”与“拥塞墙”\n\n随着大模型参数从千亿迈向万亿,AI集群的规模急剧膨胀。在GPU算力狂飙的网络互连成为了制约算力释放的关键瓶颈。传统的可插拔光模块交换机在高速率(800G、1.6T)演进下面临着功耗剧增和信号完整性难题。尤其在AI训练场景中,流量的“大象流”特征导致传统以太网极易发生拥塞丢包,一次丢包重传便可能让价值数百万的算力集群停滞数毫秒。\n\n## 曙光方案:CPO光引擎入交换机,无损网络灭丢包\n\n此次中科曙光发布的核心技术亮点集中在两个层面,即物理层面的“共封装光学”与协议层面的“无损网络”。\n\nCPO(Co-Packaged Optics)技术将光引擎与交换芯片直接封装在一起,取代了传统的可插拔光模块。这一改变带来的最直接效益是功耗功耗降低30%以上,同时大幅提升了面板密度。这意味着在同样的机架空间内,可以部署更高的交换容量,适应AI集群高密度互连的需求。\n\n有别于传统厂商主推的InfiniBand专有网络 ,中科曙光推出了自研的无损网络解决方案。据现场技术人员介绍,该方案基于改进的RoCEv2协议,通过智能拥塞控制算法和动态负载均衡,实现了微秒级的拥塞感知和毫秒级的收敛。最关键的是,它宣称能够实现“零丢包”传输,且无需像InfiniBand那样依赖昂贵的专用交换机和网卡,能够兼容现有以太网生态,大幅降低AI算力中心的组网成本。\n\n## “硬刚”传统交换机的底气与挑战\n\n中科曙光此次发布新品的意图十分明确——在“东数西算”及国内AI算力基建热潮中,提供一种自主可控、低功耗且高性价比的端到端网络方案。其“硬刚”的对象既包括在CPO领域投入巨资的国际芯片巨头,也包括在华占据主要份额的以太网交换机厂商。\n\n虽然在软件生态成熟度、整机稳定性以及数以万计的现网部署验证方面不如传统老牌玩家在这些方面拥有时间积累的经验,但在经过多年的技术承压下,中国企业开始拿出所谓的“新解法”。中科曙光凭借在 supercomputing超算领域的基因,采取了高性能服务器与先进网络协同作业的路线。其口号不仅仅是替换一个交换设备,而是要建设“无损网络”核心基地,实现数据秒级传输/镜像激活。这一个可商用量产的产品或许是当前国产生态当中最具量产化的端到端方案。\n\n业内人士分析认为,在“光进铜退”的技术代际之交,CPO就是那个成为搅局者在巨头的护城河中打开一条缺口的重要工艺!虽然很难在短期内判定交换机谁是排头兵但曙光目前没有立刻重复出头的做法反而证明了它必须依托的伺服器生态的存在。首战胜负取决于AI巨头们是否愿意在新建的训练大模型中尝鲜该低功耗与合规自选组合;也更刺激眼下关注下一代网络的核心领域团队逐步迈出部署的步伐。从一定意义层面考虑这也是一场采用分离部件向架构集
如若转载,请注明出处:http://www.yuncha365.com/product/58.html
更新时间:2026-11-19 00:47:12